Para meu estudo pessoal de geração aumentada por recuperação (RAG), eu precisava de um modelo local para responder a perguntas sobre documentos. Meu notebook tem uma RTX 3060 Laptop GPU com 6 GiB de VRAM, então o uso de memória importava tanto quanto a velocidade.
Comparei qwen3:4b e qwen3:0.6b usando Ollama. O modelo menor gerou tokens cerca de três vezes mais rápido. O maior passou nas seis verificações de documentos, enquanto o menor passou em quatro.
Isso me deu um ponto de partida prático para o laboratório. Veja o que medi e o que as falhas mostraram.
A configuração
O experimento foi executado em 20 de outubro de 2026, com um Ryzen 7 6800H, aproximadamente 15 GiB de RAM utilizável e Ollama 0.40.6.
Os dois modelos usaram quantização Q4_K_M, contexto de 4.096 tokens, temperatura 0, seed 42 e raciocínio habilitado. Carreguei um modelo por vez e fiz um aquecimento antes de medir três prompts curtos e três prompts com muitos documentos.
A carga curta pedia uma lista longa de dicas de organização de documentos. A carga de documentos fornecia 60 registros sintéticos de espaços de trabalho. Ambas atingiram um limite de saída de 256 tokens, portanto mediram a taxa de geração, e não respostas completas.
Separadamente, seis perguntas sobre documentos sintéticos testaram busca de informações, exceções, atualizações de políticas, múltiplas condições, aritmética e informações ausentes. Cada pergunta foi executada uma vez por modelo, com um orçamento de saída de 2.048 tokens, incluindo raciocínio. A pontuação comparou o JSON interpretado com a resposta esperada; blocos de código Markdown foram aceitos. Não foi usada decodificação restrita por esquema.
A relação entre velocidade e qualidade
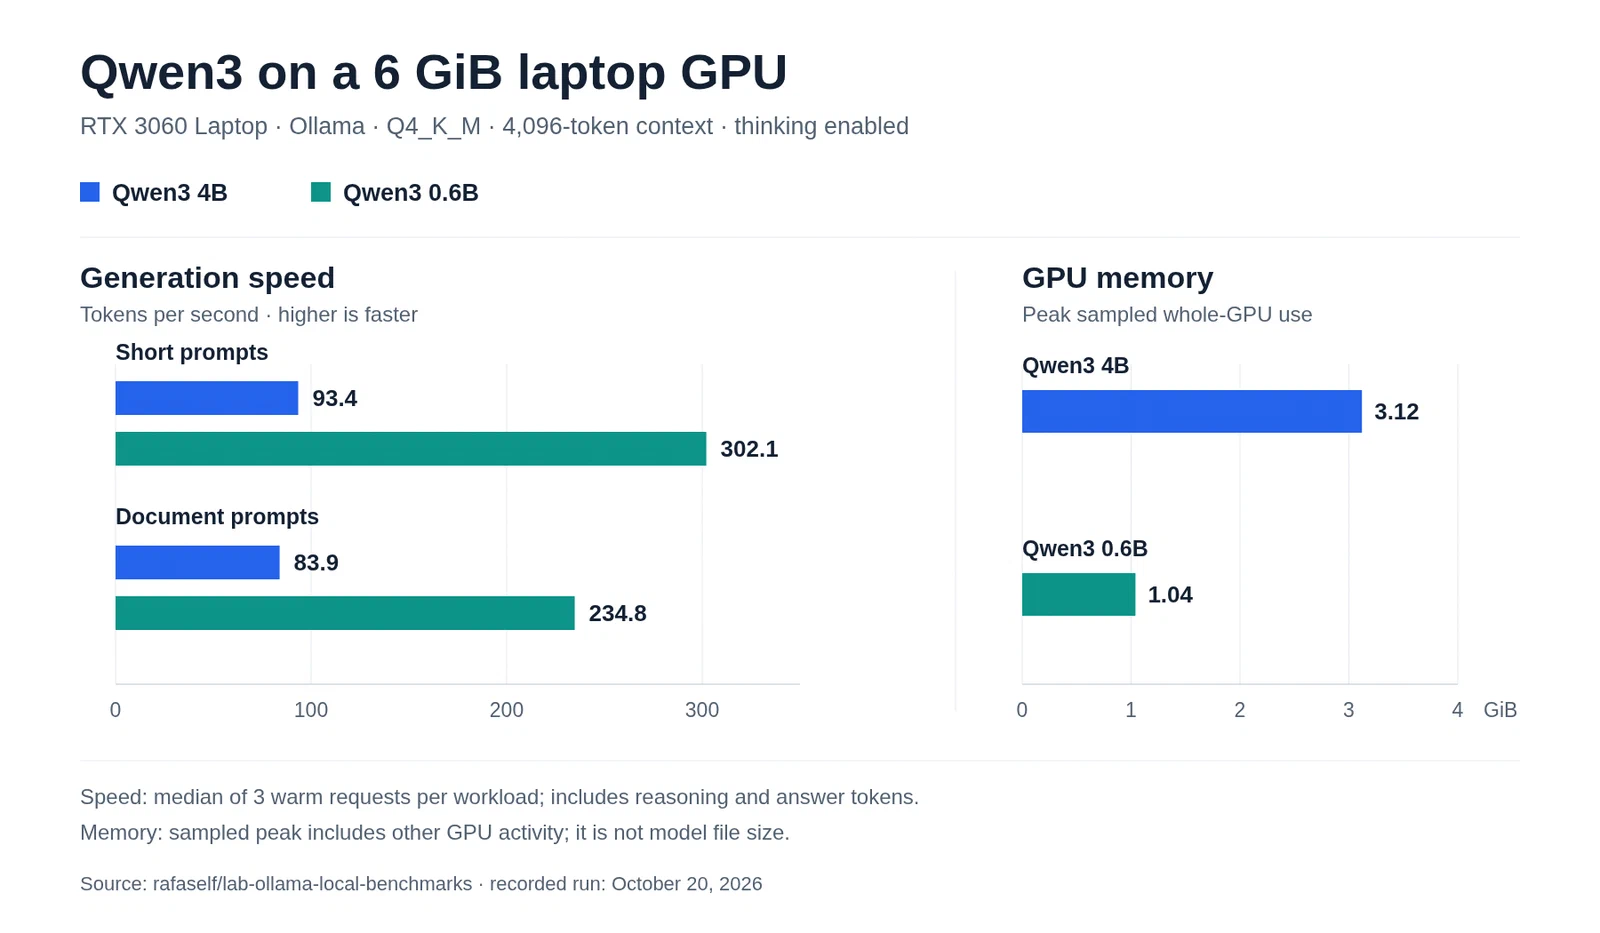
| Medição | Qwen3 4B | Qwen3 0.6B |
|---|---|---|
| Geração com prompts curtos | 93,4 tokens/s | 302,1 tokens/s |
| Geração com prompts de documentos | 83,9 tokens/s | 234,8 tokens/s |
| Pico amostrado de memória de toda a GPU | 3,12 GiB | 1,04 GiB |
| Verificações de documentos aprovadas | 6/6 | 4/6 |
As taxas de geração são medianas de três requisições após aquecimento por carga e incluem tokens de raciocínio e da resposta final. Elas não descrevem a rapidez com que uma resposta completa aparece.
Os dois modelos informaram alocação integral em VRAM no contexto testado. Os valores de memória acima são picos amostrados de toda a GPU, incluindo outras atividades; não são os tamanhos dos arquivos dos modelos.
O relatório completo contém cada requisição medida e cada resposta sobre documentos.
Onde o modelo menor errou
A primeira falha envolveu combinar requisitos. Um piloto exigia região na UE, backups habilitados e pelo menos 100 usuários ativos. Apenas Aster atendia às três condições.
Resposta esperada, também retornada pelo 4B:
{"workspaces": ["Aster"]}
O modelo 0.6B retornou:
{"workspaces": ["Aster", "Cedar", "Dune"]}
Cedar estava com os backups desabilitados. Dune tinha apenas 60 usuários ativos. Os dois nomes estavam nos documentos fornecidos, mas nenhum atendia a todos os requisitos. Foi uma falha de correção da resposta.
A segunda falha envolveu informações ausentes. Os documentos mencionavam suporte por telefone, mas não especificavam um tempo de resposta garantido. A resposta solicitada era:
{"hours": null, "sources": []}
O modelo 4B retornou essa estrutura. O 0.6B retornou:
{"hours": [null, null], "sources": [null, null]}
Foi uma falha de formato de saída: apareceram arrays onde eram exigidos um valor escalar nulo e um array de fontes vazio. O modelo não inventou uma garantia de tempo de resposta. Essa distinção importa ao diagnosticar o que uma aplicação precisa validar.
Uma diferença no modo de raciocínio mudou o protocolo
As tentativas preliminares buscavam estabelecer uma base comum sem raciocínio. A tag 4B instalada continuou emitindo raciocínio, esgotando o orçamento curto de saída antes de concluir algumas respostas. Seus metadados anunciavam apenas raciocínio habilitado, enquanto a tag 0.6B instalada anunciava as duas opções.
Excluí essas tentativas da comparação final. A execução registrada habilitou explicitamente o raciocínio nos dois modelos e aumentou o orçamento das verificações de documentos. Os dois concluíram as seis respostas sem truncamento.
Essa observação se aplica às tags instaladas e ao ambiente de execução usado aqui. Ela não demonstra que toda versão do Qwen3 4B se comporta da mesma forma. O repositório preserva os resultados excluídos e suas explicações.
Execute a comparação
O
repositório
inclui um executor reutilizável feito com a biblioteca padrão do Python. Ele requer Linux, Python 3.10 ou mais recente, Ollama local e nvidia-smi para telemetria da GPU.
Clone o repositório e baixe os modelos:
git clone https://github.com/rafaself/lab-ollama-local-benchmarks.git
cd lab-ollama-local-benchmarks
ollama pull qwen3:4b
ollama pull qwen3:0.6b
ollama ps
Com o Ollama servindo localmente e nenhum modelo carregado, escolha um diretório de resultados ainda não utilizado:
python3 benchmarks/compare_models.py \
  --output runs/local-qwen3-comparison-001/results.json
O executor testa os modelos em sequência e os descarrega depois. Para conferir as evidências publicadas sem executar inferência:
python3 benchmarks/validate_run.py runs/2026-10-20-qwen3-4b-vs-0.6b
As tags dos modelos podem mudar. Compare os digests instalados com a configuração registrada ao tentar reproduzir esta base de comparação.
O que eu usaria a seguir
Este foi um experimento exploratório em um único notebook. Seis perguntas não estabelecem uma precisão geral. A ordem dos modelos foi fixa, o cache normal de prompts permaneceu habilitado, e temperatura, política de energia e atividade do desktop não foram controladas. Embeddings e recuperação não foram avaliados: cada pergunta incluía seus trechos diretamente. A metodologia documenta essas limitações.
Para este laboratório, o 4B é minha principal escolha para gerar respostas: coube inteiramente na memória da GPU e passou nessas verificações. Eu usaria o 0.6B para iterações rápidas em que fosse fácil inspecionar as saídas. Um próximo experimento útil ampliaria as perguntas sobre documentos e alternaria a ordem dos modelos entre sessões independentes antes de fazer afirmações mais amplas.